Техническое SEO · интернет-магазины
Faceted Navigation SEO: как фильтры создают миллионы URL — и что с этим делать
Цвет, размер, бренд, цена, наличие: каждый выбор добавляет параметр, каждый параметр — новый адрес. Разбираем, откуда берутся миллионы URL, как их найти в данных и какой набор инструментов решает задачу без потери ценных посадочных страниц.
- в индексе/catalog/notebooks/
- в индексе/catalog/notebooks/asus/
- canonical/catalog/notebooks/?brand=asus&sort=price
- закрыть/catalog/notebooks/?brand=asus&ram=16&disk=ssd&color=orange
Одна категория — четыре строки. В реальном каталоге таких строк десятки тысяч: решение по каждому URL не масштабируется, решение по каждому типу параметра — да.
Коротко о главном
Если времени на длинное чтение нет — семь правил, которые закрывают большую часть проблем с фильтрами каталога.
- Сначала классификация, потом robots.txt
Массовое закрытие параметров уносит вместе с мусором ценные посадочные страницы. Сначала разложите фильтры по типам.
- robots.txt ≠ noindex
Закрытый в robots.txt URL робот не открывает — значит, директиву noindex он не прочитает. Это два разных инструмента для разных задач.
- Canonical — сигнал, а не приказ
Если комбинация фильтров реально отвечает спросу, canonical на родительскую категорию похоронит посадочную страницу.
- Ценным комбинациям — постоянные адреса
Набор GET-параметров неудобен для пользователя и нестабилен для индекса. Нужен полноценный URL вида /catalog/notebooks/asus/.
- Порядок параметров = дубли
?brand=asus&color=black и ?color=black&brand=asus — один и тот же набор, но два адреса. Нормализация решает проблему на уровне приложения.
- Пустая выдача — это 404
Комбинация без товаров не должна отдавать 200 OK: иначе поисковая система получает тысячи пустых страниц вместо честного сигнала «здесь ничего нет».
- Считайте долю обхода, а не число URL
Метрика Parameter Crawl Share показывает, сколько ресурсов робот тратит на фильтры — до и после внедрения.
Все числовые примеры в статье — демонстрационные модели, а не данные реальных клиентских проектов.
Навигация и быстрый расчёт
Слева — карта статьи. Справа — калькулятор: подставьте значения своих фильтров и сразу увидите верхнюю границу числа URL, а также подсказку, что с этим делать.
Калькулятор комбинаций фильтров
Формула та же, что в статье: N = (значений + 1) в каждом фильтре, перемноженные, минус один. Значение «+1» — это вариант «фильтр не выбран».
Фильтры категории
Добавьте фильтры, чтобы увидеть оценку.
Расчёт даёт верхнюю границу: реальное число ограничено ассортиментом и логикой каталога. Но даже небольшая доля от этой величины способна съесть краулинговый бюджет.
Часть 1. Как фильтры создают миллионы URL
Механика проблемы: как пять обычных фильтров превращают одну категорию в десятки тысяч адресов, и какие из этих адресов действительно нужны поиску.
Что такое Faceted Navigation
Faceted Navigation — фасетная навигация, то есть система фильтрации товаров или материалов по набору характеристик. Каждый фильтр представляет отдельное свойство объекта, а комбинация нескольких фильтров формирует более узкую выборку.
Для посетителя это удобный инструмент. Для поискового робота — потенциально бесконечная система генерации URL.
Например, в категории «Ноутбуки» пользователь может выбрать:
- производителя — ASUS;
- диагональ — 15,6 дюйма;
- объём оперативной памяти — 16 ГБ;
- тип накопителя — SSD;
- цену — от 50 000 до 100 000 рублей.
Если каждый выбранный параметр формирует отдельный URL, система начинает создавать дополнительные адреса:
/catalog/notebooks/
/catalog/notebooks/?brand=asus
/catalog/notebooks/?brand=asus&diagonal=15
/catalog/notebooks/?brand=asus&diagonal=15&ram=16
/catalog/notebooks/?brand=asus&diagonal=15&ram=16&disk=ssd
/catalog/notebooks/?brand=asus&diagonal=15&ram=16&disk=ssd&price_from=50000
Каждый такой URL может быть доступен поисковому роботу. Если фильтры реализованы без ограничений, поисковая система получает возможность обнаруживать всё новые комбинации.
Математика: откуда берутся миллионы
Чтобы понять масштаб проблемы, достаточно рассмотреть арифметическую модель фасетной навигации.
| Фильтр | Количество доступных значений |
|---|---|
| Бренд | 8 |
| Цвет | 10 |
| Размер | 6 |
| Материал | 4 |
| Производитель | 5 |
Если пользователь может выбрать одно значение из каждого фильтра или не выбирать его вообще, количество потенциальных комбинаций составит:
N = (8 + 1) × (10 + 1) × (6 + 1) × (4 + 1) × (5 + 1) - 1

N = 9 × 11 × 7 × 5 × 6 - 1

N = 20 789 комбинаций
Это только одна категория. Если аналогичная система работает в 80 категориях, теоретическое пространство составит:
Верхняя граница пространства URL
20 789 × 80 = 1 663 120 потенциальных комбинаций URL.
Это не означает, что все адреса будут созданы, открыты для обхода или проиндексированы. Но даже небольшая доля от потенциального пространства способна создать серьёзную проблему.
Посчитать это для своих данных можно в калькуляторе выше — он работает по той же формуле и сразу подсказывает, насколько велик разрыв.
Дополнительные источники разрастания URL
Фильтры — не единственный источник. В реальных интернет-магазинах к ним часто добавляются:
- сортировка по цене, популярности, рейтингу и дате;
- изменение количества товаров на странице;
- переключение вида отображения каталога;
- пагинация;
- параметры наличия товара;
- диапазоны стоимости;
- сочетания нескольких вариантов одного параметра;
- параметры аналитики и рекламных кампаний;
- сессионные идентификаторы и временные значения.
Особенно опасна комбинация нескольких механизмов. Например, пользователь выбирает бренд, цвет и размер, затем сортирует товары по цене и переходит на третью страницу. В результате формируется URL, который отличается от исходной категории сразу несколькими параметрами.
Какие типы URL создаёт фасетная навигация
Перед тем как менять robots.txt или добавлять canonical, необходимо понять, какие именно URL генерирует система. Не все параметры одинаково полезны и не все требуют одинаковой обработки.
| Тип параметра | Пример | Типичная SEO-ценность | Рекомендуемое решение |
|---|---|---|---|
| Бренд | ?brand=bosch | Может быть высокой | Оценить спрос, при необходимости создать посадочную |
| Цвет | ?color=black | Зависит от категории | Индексировать только ценные сочетания |
| Размер | ?size=xl | Зависит от спроса | Оценить спрос и наличие товаров |
| Цена | ?price_from=1000 | Обычно ограниченная | Не допускать произвольного размножения диапазонов |
| Сортировка | ?sort=price_asc | Обычно отсутствует | Не создавать отдельные индексируемые страницы |
| Количество товаров | ?per_page=100 | Обычно отсутствует | Не индексировать варианты отображения |
| Наличие | ?stock=yes | Зависит от проекта | Проверить стабильность и поисковый спрос |
| Рейтинг | ?rating=4 | Обычно ограниченная | Оставлять только при доказанной ценности |
| Пагинация | ?page=2 | Может быть важна для обнаружения товаров | Отдельная логика обработки пагинации |
| Технические параметры | ?sessionid=123 | Отсутствует | Исключить из индексируемой архитектуры |
Важно
Это не универсальная таблица запретов. Фильтр по бренду может быть чрезвычайно ценным в категории бытовой техники и практически бесполезным в категории расходных материалов с небольшим ассортиментом. Решение принимается на основании поискового спроса, состава товаров, коммерческой ценности и фактического поведения поисковых систем.
Часть 2. Диагностика: найти проблему в данных
Аудит начинается не с редактирования robots.txt, а с ответа на три вопроса: сколько URL генерирует каталог, какие из них обходит робот и какие действительно попали в индекс.
Самая частая ошибка — закрыть все фильтры в robots.txt
Когда SEO-специалист обнаруживает десятки тысяч параметрических URL, первое желание — закрыть все параметры через robots.txt. Иногда это правильное решение. Но массовое закрытие без предварительной классификации приводит к потере потенциально полезных посадочных страниц.
Представим категорию «Стиральные машины». В ней есть фильтр по бренду и типу загрузки. Комбинация
/catalog/washing-machines/?brand=bosch&loading=frontможет соответствовать самостоятельному поисковому запросу и иметь коммерческий потенциал. Если закрыть все URL с параметром brand, такая страница тоже окажется вне нормального обхода.
Почему robots.txt не заменяет noindex
robots.txt управляет доступом робота к URL. Директива noindex сообщает поисковой системе, что доступная для обхода страница не должна включаться в индекс.
Типичная техническая ошибка
Добавить URL фильтра в robots.txt и одновременно рассчитывать, что Google прочитает на нём noindex. Эти механизмы не работают как единая команда: закрытый от обхода URL не отдаёт роботу содержимое страницы, а значит, директиву он не увидит.
Если нужно исключить страницу из индекса через noindex, робот должен иметь возможность её просканировать. Если задача — сократить обход бесконечных комбинаций, подходит robots.txt. Но сначала необходимо оценить, не блокируются ли вместе с ними ценные страницы.
Пять этапов диагностики
Шаг 1. Сбор URL и карта параметров
Первый источник — сам сайт. Нужно пройти основные категории и последовательно проверить все фильтры. Фиксируем:
- количество фильтров в каждой категории;
- количество значений внутри каждого фильтра;
- возможность одновременного выбора нескольких значений;
- формат формирования URL и порядок параметров;
- наличие сортировки и пагинации;
- поведение при сбросе фильтра;
- поведение при выборе комбинации без товаров.
Отдельно проверяем, может ли один и тот же набор фильтров формировать несколько адресов:
/catalog/laptops/?brand=asus&color=black
/catalog/laptops/?color=black&brand=asus
Если оба URL показывают одинаковый набор товаров, но система считает их разными адресами, появляется дополнительная вариативность.
Шаг 2. Проверка через Screaming Frog SEO Spider
Краулер позволяет обнаружить URL с параметрами, проанализировать внутренние ссылки, коды ответа, canonical и robots directives. Рекомендуемый порядок работы:
- запустить обход основных категорий сайта;
- включить обработку JavaScript, если фильтры формируют ссылки или контент через JS;
- собрать URL, содержащие параметры, и выгрузить адреса с query string;
- сгруппировать их по названиям параметров;
- проверить canonical для каждой группы;
- найти URL с одинаковыми title, H1 и близким содержимым;
- отдельно проверить страницы с нулевым количеством товаров.
Важный нюанс: обычный краулер не обязательно обнаружит всё пространство возможных комбинаций — он находит URL, до которых может добраться по ссылкам. Поэтому результат нужно сопоставлять с выгрузкой URL из CMS, Search Console и серверных логов.
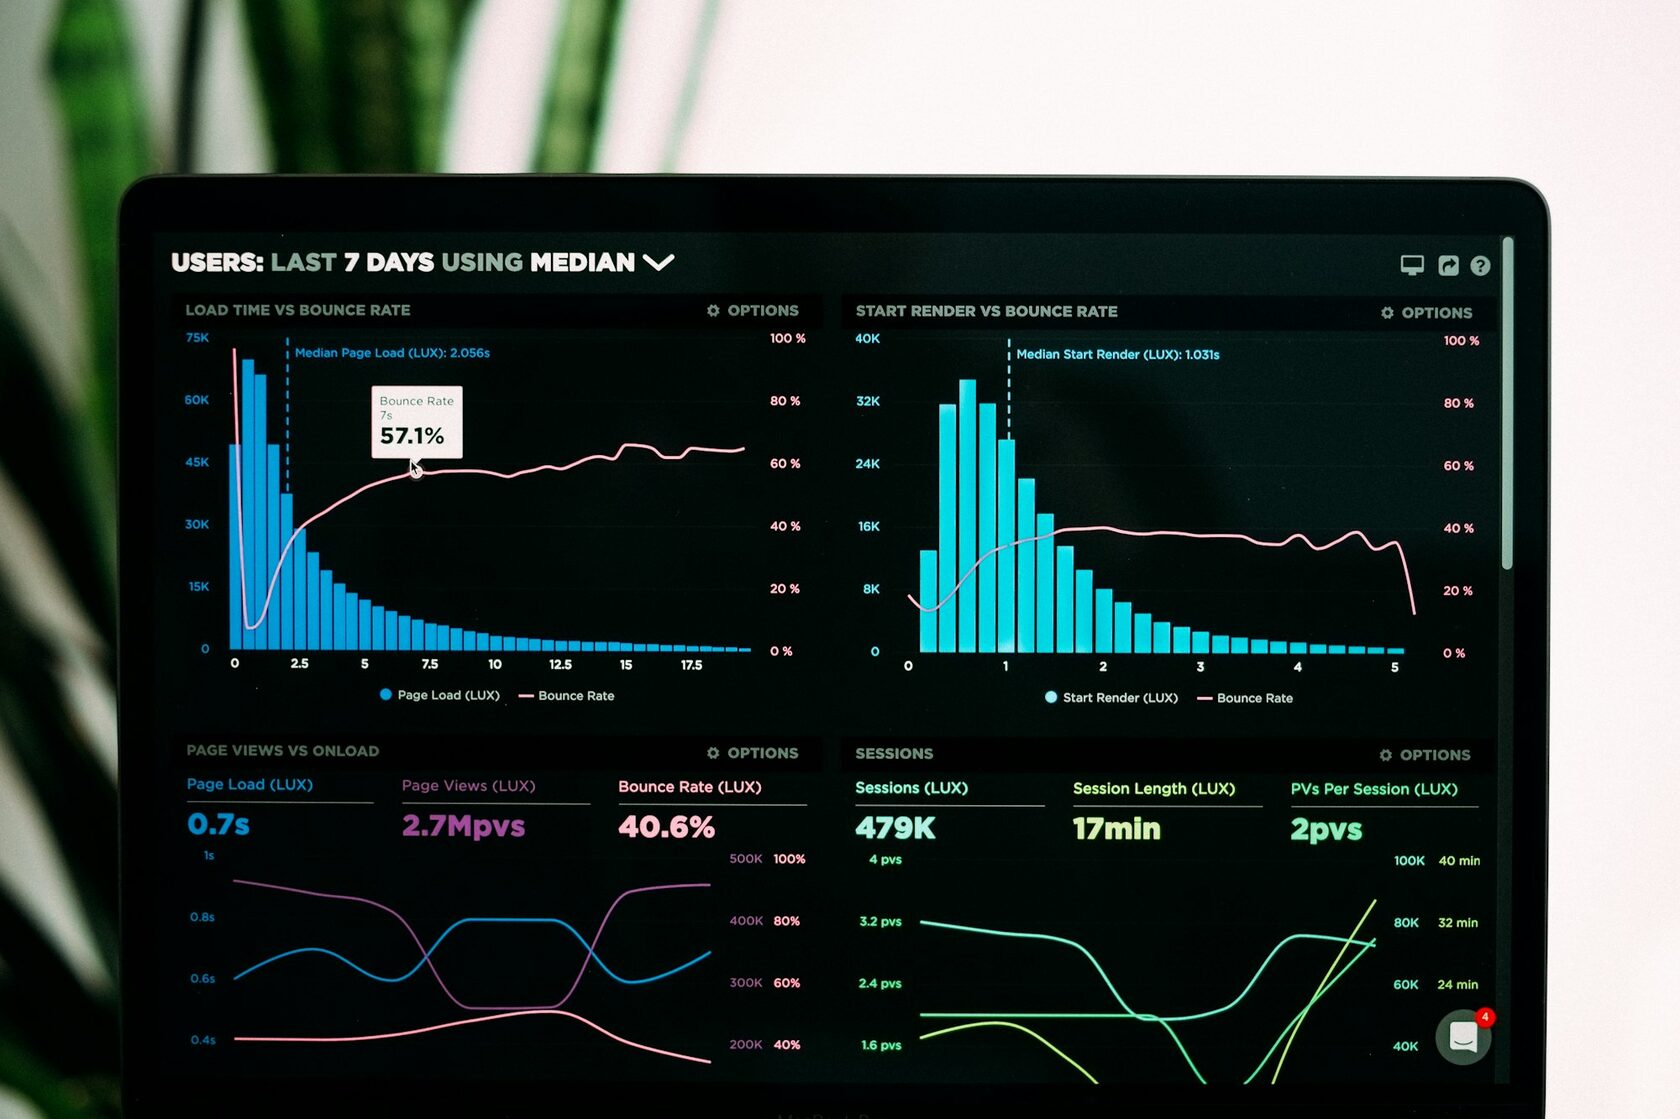
Шаг 3. Анализ структуры параметров
Допустим, после обхода сайта получена следующая выборка. Это демонстрационные данные, а не статистика реального проекта.
| Группа URL | Количество обнаруженных адресов | Доля |
|---|---|---|
| Чистые категории | 1 250 | 5% |
| Фильтры бренда | 3 800 | 15,2% |
| Фильтры цены | 4 600 | 18,4% |
| Комбинации фильтров | 8 900 | 35,6% |
| Сортировка и отображение | 3 200 | 12,8% |
| Пагинация и прочее | 3 250 | 13% |
| Всего | 25 000 | 100% |
На первый взгляд, 25 тысяч URL — не критическое число для крупного магазина. Но важно не только количество, а структура этих адресов. Если большая часть URL создаётся сочетаниями параметров цены, сортировки и бренда, которые не имеют самостоятельного спроса, сайт расходует ресурсы на поддержание огромного количества практически одинаковых состояний каталога.
Шаг 4. Проверка индексации через Google Search Console
В Search Console необходимо изучить отчёты об индексировании страниц и выборочно проверить параметрические URL через инструмент проверки URL. Что анализируем:
- сколько URL обнаружено, но не проиндексировано;
- сколько адресов исключено по причине дублирования;
- какие страницы Google считает альтернативными страницами с canonical;
- какие URL имеют выбранный Google canonical, отличный от указанного сайтом;
- попадают ли в индекс страницы сортировки и технические комбинации;
- появляются ли фильтры в поисковых запросах как посадочные страницы.
Важно не путать обнаруженные, просканированные и проиндексированные URL — это разные состояния. Сам факт появления параметрического адреса в отчётах не доказывает, что он находится в индексе.
Шаг 5. Анализ серверных логов
Самый важный этап для крупных интернет-магазинов — проверка фактической активности поисковых роботов. Логи показывают, какие URL запрашивал Googlebot, когда это происходило, какой код ответа вернул сервер и насколько часто повторяются обращения к одним и тем же группам параметров.
2026-10-12 10:15:22 Googlebot GET /catalog/laptops/?brand=asus 200
2026-10-12 10:15:25 Googlebot GET /catalog/laptops/?brand=asus&color=black 200
2026-10-12 10:15:29 Googlebot GET /catalog/laptops/?brand=asus&sort=price 200
2026-10-12 10:15:31 Googlebot GET /catalog/laptops/?brand=asus&sort=price&page=2 200
2026-10-12 10:15:35 Googlebot GET /catalog/laptops/?color=black&brand=asus 200
В этом примере робот последовательно обращается к разным вариантам одной категории. Для анализа подходят Screaming Frog Log File Analyser, серверные логи и собственные SQL/Python-скрипты.
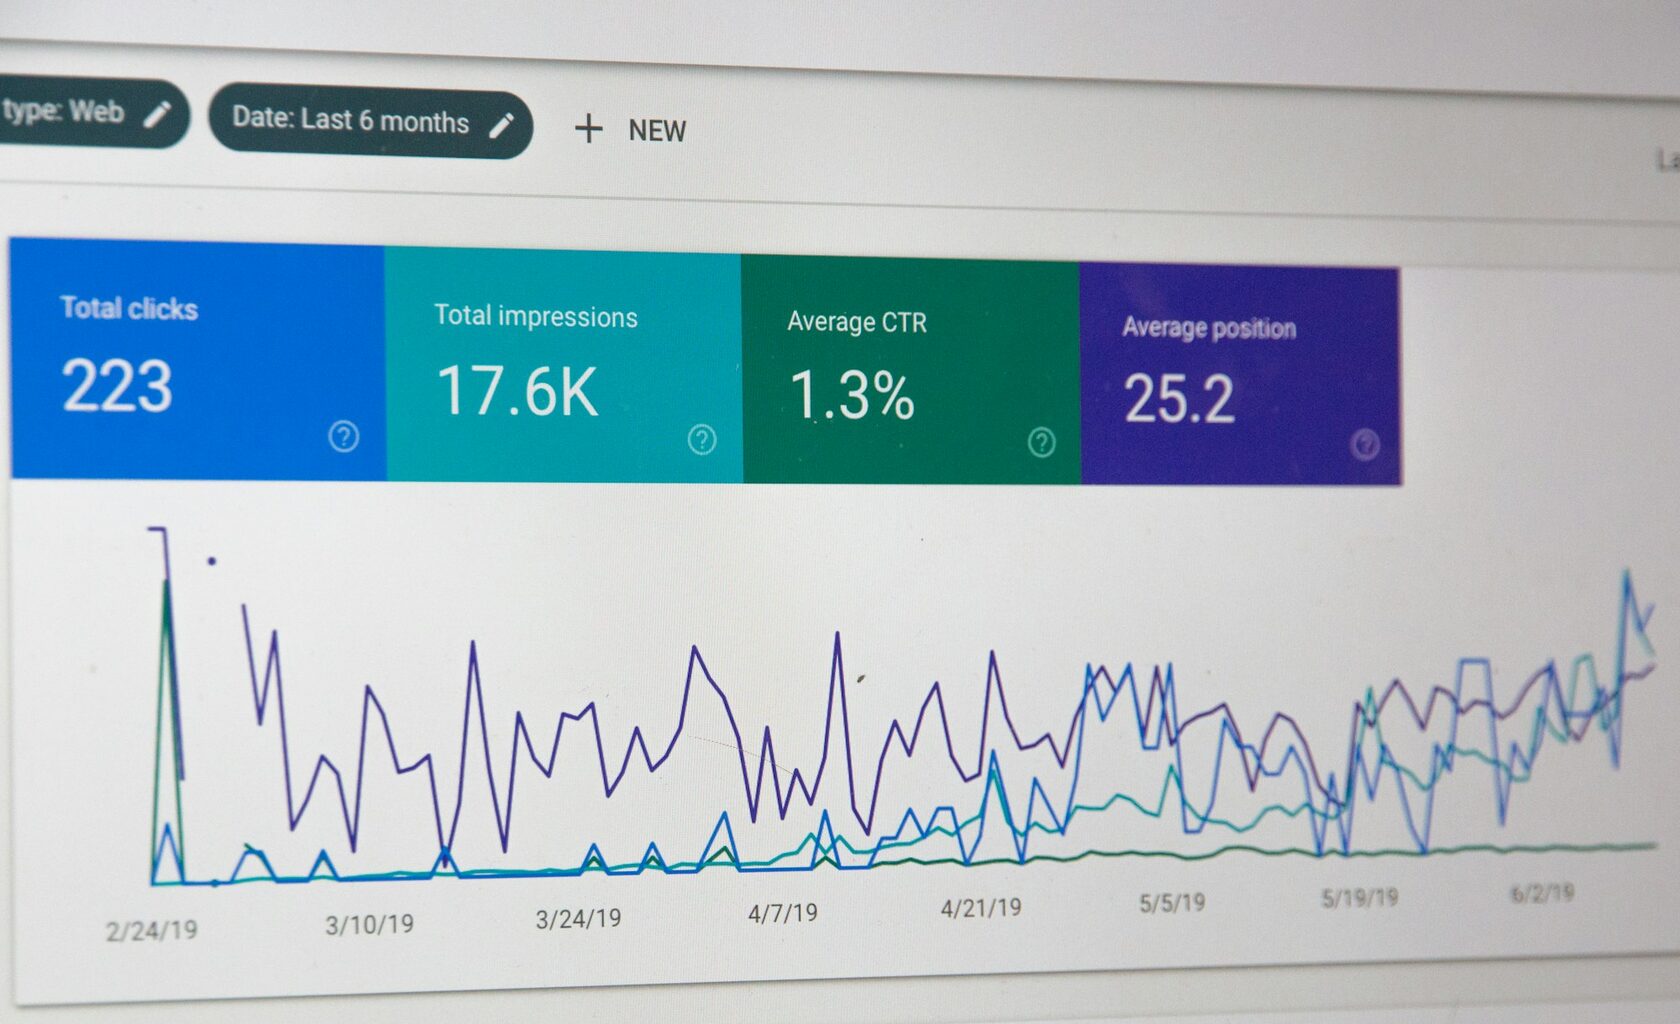
Для корректного анализа нужно проверять подлинность запросов Googlebot по официальным рекомендациям Google по верификации поисковых роботов. Нельзя считать любой User-Agent с названием Googlebot подтверждённым Googlebot.
Метрики и план на 10 минут
Для диагностики рекомендую сформировать отдельную таблицу показателей.
| Метрика | Что показывает | Как использовать |
|---|---|---|
| Faceted URL Count | Количество обнаруженных URL фильтров | Оценка масштаба генерации адресов |
| Parameter Crawl Share | Доля запросов робота к параметрическим URL | Оценка структуры обхода |
| Indexed Facet URLs | Количество проиндексированных страниц фильтров | Контроль попадания лишних страниц в индекс |
| Duplicate Facet Groups | Количество групп похожих страниц | Поиск дублей и альтернативных URL |
| Zero-result URLs | Количество комбинаций без товаров | Проверка обработки пустых результатов |
| Canonical Mismatch | Несоответствие canonical и выбранного Google canonical | Поиск проблем каноникализации |
| Important URL Crawl Frequency | Частота обхода важных категорий и товаров | Контроль обнаружения ключевых страниц |
Один из полезных показателей — доля обращений подтверждённых поисковых роботов к параметрическим URL:
Parameter Crawl Share =
(Googlebot requests to faceted URLs /
All Googlebot HTML requests) × 100%
Например, если за анализируемый период Googlebot совершил 100 000 запросов HTML-страниц, из которых 42 000 пришлись на URL с фильтрами, показатель составит 42%. Это не норматив Google и не оценка качества сайта: метрика нужна для сравнения состояния проекта до и после изменений.
План на 10 минут: с чего начать прямо сейчас
- Откройте логи за 30 днейВыгрузите все запросы к URL, содержащим знак «?». Один SQL-запрос к таблице логов даёт полную картину масштаба.
- Отсортируйте по параметрамСгруппируйте адреса по именам параметров: сколько URL приходится на brand, на sort, на price. Две трети проблемы обычно видны сразу.
- Проверьте 20 самых частых комбинацийОткройте их вручную: что показывает страница, какой canonical, какой HTTP-статус. Этого достаточно, чтобы понять модель поведения сайта.
- Сравните с Search ConsoleВыборочно проверьте 10–15 URL через инструмент проверки URL — сколько из них реально в индексе.
- Запишите базовые значения метрикParameter Crawl Share и количество индексированных фасетных URL — это точка отсчёта, без которой эффект изменений невозможно оценить.
Часть 3. Что индексировать, а что оставить фильтром
Здесь начинается основная работа: перестать воспринимать все фильтры как одинаковые элементы интерфейса и разделить их по назначению.
Трёхуровневая модель фильтров
Ценные SEO-посадочные страницы
Фильтры или сочетания характеристик, которые соответствуют самостоятельным поисковым запросам:
- купить ноутбук ASUS;
- купить чёрный диван;
- красные женские кроссовки;
- цемент М500 купить;
- смесители Grohe для кухни.
Если у комбинации есть поисковый спрос, достаточное количество товаров и понятное коммерческое намерение, её можно рассматривать как отдельную посадочную страницу. Но открывать технический URL с параметрами для индексации не стоит — лучше создать контролируемую страницу с постоянным адресом, уникальными метаданными, понятным H1 и устойчивым набором товаров:
Формат постоянных адресов
/catalog/notebooks/asus/
/catalog/sofas/black/
/catalog/sneakers/womens/red/
Такие страницы должны иметь собственную логику существования: понятный URL, корректный canonical, внутренние ссылки и включение в sitemap, если они предназначены для индексации.
Пользовательские фильтры без самостоятельной SEO-ценности
Параметры, которые помогают покупателю уточнить выбор, но не обязаны становиться страницами поиска:
- сортировка по возрастанию цены и по популярности;
- показ только товаров в наличии;
- выбор количества карточек на странице;
- переключение сетки и списка;
- временные пользовательские настройки.
Для таких состояний нужно определить механизм, который не позволит им бесконтрольно формировать индексируемые URL: нормализация, canonical на родительскую категорию или закрытие от обхода.
Технические и бесполезные комбинации
Сочетания, которые не дают ценности и могут генерироваться практически бесконечно:
- несуществующие комбинации характеристик;
- повторяющиеся параметры;
- произвольные диапазоны цен;
- комбинации с нулевым количеством товаров;
- временные идентификаторы;
- бесконечные варианты сортировки и отображения.
Здесь основная задача — исключить бессмысленную генерацию адресов, корректно обрабатывать ошибки и ограничить обход ненужных комбинаций.
Матрица решения: 5 критериев и 100 баллов
Чтобы не принимать решения вручную для каждого URL, разработайте матрицу оценки фильтров. Для каждого сочетания оцениваем пять факторов:
| Критерий | Максимальный балл | Что проверяем |
|---|---|---|
| Поисковый спрос | 30 | Есть ли реальные запросы пользователей |
| Коммерческий потенциал | 25 | Соответствует ли комбинация намерению купить |
| Ассортимент | 20 | Достаточно ли товаров для полноценной страницы |
| Уникальность | 15 | Отличается ли страница от родительской категории |
| Стабильность | 10 | Не исчезнет ли страница из-за постоянного изменения ассортимента |
- 70–100 баллов: кандидат на отдельную SEO-посадочную страницу.
- 40–69 баллов: дополнительная проверка спроса, ассортимента и конкуренции.
- 0–39 баллов: обычно нет оснований создавать отдельную индексируемую страницу.
Важное ограничение
Эта система баллов — рабочая модель для SEO-аудита, а не официальный алгоритм Google. Она помогает структурировать решения, но не заменяет анализ поисковой выдачи и реальных данных проекта.
Как подтвердить, что по фильтру действительно есть спрос
Оценка «на глаз» почти всегда ошибается: внутренние ощущения команды не равны поисковому спросу. Надёжнее собрать подтверждение из нескольких независимых источников.
- Google Search Console
Отчёт «Поисковые запросы» по уже существующим фильтрам: если страница фильтра приносит показы и клики, спрос подтверждён фактом, а не гипотезой.
- Яндекс.Вебмастер
Аналогичная отчётность и разбивка по страницам. Для проектов с заметной долей трафика из Яндекса это обязательная часть проверки.
- Поисковые подсказки и related-запросы
Быстрый и бесплатный способ увидеть форму запроса: «купить …» + значение фильтра. Формулировка подсказки часто сразу подсказывает будущий URL посадочной страницы.
- Прогноз спроса
Wordstat, Алиса, Serpstat или аналогичные сервисы дают частотность запроса и его сезонность — это помогает не создавать страницу под микроспрос, который не окупит её поддержку.
- Конкуренты
Если у конкурентов есть отдельные посадочные по фильтрам — смотрите их структуру, заголовки и объём ассортимента. Это самая честная проверка коммерческого потенциала.
- Поведение самих фильтров
Самый недооценённый источник: данные аналитики о том, какие фильтры и значения выбирают покупатели. Это прямой ответ на вопрос «какие комбинации имеют смысл».
Практический вывод
Спрос подтверждается минимум двумя независимыми источниками. Один источник — это мнение, два — уже сигнал, три — основание для создания постоянной посадочной страницы.
Полезная привычка: завести таблицу «фильтр → подтверждённый спрос → источник подтверждения → решение». Через квартал эта таблица сама покажет, где стратегия устарела.
Часть 4. Технические механизмы
robots.txt, canonical, noindex, нормализация и перелинковка — пять инструментов с разными задачами. Ошибка в выборе инструмента стоит дороже, чем его отсутствие.
Памятка: какой инструмент когда
| Задача | Инструмент | Важное условие |
|---|---|---|
| Убрать страницу из индекса, оставив доступной | noindex или X-Robots-Tag | Робот должен видеть страницу, чтобы прочитать директиву |
| Сэкономить краулинговый бюджет | robots.txt | Страница перестаёт отдавать noindex — учтите это |
| Объединить дубли и варианты | canonical | Сигнал, а не приказ: робот может выбрать другой URL |
| Убрать мусорные комбинации | Нормализация, 404, 301 | Не редиректить всё подряд — проверяйте эквивалентность |
| Убрать URL из пути робота | Перелинковка, nofollow | На все ссылки на конкретный URL нужен один и тот же rel |
| Сделать посадочную страницу | Постоянный URL + sitemap + внутренние ссылки | Уникальный H1, title и собственная выдача товаров |
robots.txt: как ограничить обход ненужных фильтров
Если определённая группа фасетных URL не должна участвовать в поиске и её не нужно сканировать, используйте robots.txt. Например, если сайт использует параметры сортировки и отображения:
User-agent: Googlebot
Disallow: /*?*sort=
Disallow: /*&sort=
Disallow: /*?*view=
Disallow: /*&view=
Disallow: /*?*per_page=
Disallow: /*&per_page=
Это только пример. Перед внедрением необходимо проверить реальные URL сайта, синтаксис правил и порядок обработки параметров: шаблон может закрыть нужные страницы или не охватить все варианты адресов.
Почему важно учитывать порядок параметров
Один и тот же параметр может находиться в начале или в середине query string:
/catalog/?sort=price&brand=bosch
/catalog/?brand=bosch&sort=price
Правило, которое учитывает только параметр после знака вопроса, не обязательно охватит его вариант после амперсанда. При разработке правил тестируйте разные комбинации — в том числе через проверку конкретного URL в инструментах вебмастера.
Не закрывайте ценное вместе с техническим
Если фильтр бренда имеет поисковую ценность, нельзя автоматически запрещать все адреса с параметром brand. Сначала выделите страницы, которые должны индексироваться, и спроектируйте отдельные постоянные URL. Для крупных проектов надёжнее отдельная архитектура SEO-посадочных страниц, чем длинный список правил robots.txt.
Canonical: когда он помогает, а когда мешает
Canonical сообщает поисковой системе, какой URL считать предпочтительной версией страницы среди дублирующих или очень похожих вариантов. Если фильтр сортировки не создаёт самостоятельной ценности, canonical может указывать на основную категорию:
<!-- URL с сортировкой -->
https://example.com/catalog/notebooks/?sort=price_asc

<!-- Canonical -->
<link rel="canonical"
      href="https://example.com/catalog/notebooks/">
Но если комбинация фильтров создаёт полноценную посадочную страницу, имеет самостоятельный спрос и отличается от родительской категории, canonical на родительский URL будет неправильным решением. У такой страницы обычно должен быть self-referencing canonical:
<link rel="canonical"
      href="https://example.com/catalog/notebooks/asus/">
Распространённая ошибка
В магазине есть категория «Кроссовки», а комбинации «мужские кроссовки», «женские кроссовки», «белые кроссовки» отвечают разным запросам. Если все они указывают canonical на общую категорию, поисковая система получает сигнал, что предпочтительна родительская страница — и ценные посадочные могут не появиться в выдаче. Canonical не является инструментом принудительного удаления URL из индекса: это сигнал каноникализации, который учитывается вместе с другими.
Noindex: когда использовать и какие ограничения учитывать
Директива noindex применяется к страницам, которые должны оставаться доступными пользователю, но не должны включаться в поисковый индекс:
<meta name="robots" content="noindex, follow">Или соответствующий HTTP-заголовок X-Robots-Tag. При этом помните:
- страница должна быть доступна поисковому роботу для чтения директивы;
- если URL одновременно закрыт в robots.txt, робот не увидит meta robots;
- noindex не является способом мгновенно остановить обход миллионов URL;
- длительное применение noindex может привести к тому, что поисковая система будет посещать страницу реже;
- нельзя автоматически добавлять noindex ко всем фильтрам без анализа поисковой ценности.
Если требуется полностью исключить техническую комбинацию из обхода, robots.txt подходит лучше. Если требуется, чтобы поисковая система увидела директиву исключения из индекса, URL должен оставаться доступным для сканирования.
Нормализация URL: устранение дублей на уровне архитектуры
Цель нормализации — добиться того, чтобы одинаковые наборы фильтров формировали одинаковый адрес независимо от последовательности действий пользователя. Вместо двух URL
/catalog/tools/?brand=bosch&color=black
/catalog/tools/?color=black&brand=bosch
система должна формировать один нормализованный вариант:
/catalog/tools/?brand=bosch&color=blackНа уровне приложения это реализуется так:
- фиксированный порядок параметров;
- удаление повторяющихся и пустых значений;
- единый регистр значений;
- стандартизация формата диапазонов цен;
- нормализация кодирования специальных символов;
- удаление технических параметров, не влияющих на состав товаров.
Если параметры пришли в другом порядке, приложение может перенаправить пользователя на нормализованный URL — при условии, что это действительно эквивалентная версия страницы. Не следует бездумно перенаправлять все неизвестные параметры: сначала проверьте, не меняют ли они содержимое страницы.
Пустые результаты фильтрации: 200 OK, soft 404 и правильная обработка
Ещё одна распространённая проблема — страницы фильтров, которые возвращают HTTP 200 OK, но не содержат ни одного товара. Например:
/catalog/notebooks/?brand=brand-x&ram=256gb&color=orangeGoogle рекомендует возвращать HTTP 404 для комбинаций, которые не дают результатов, а также для некорректных сочетаний и несуществующих страниц пагинации. Важно различать ситуации:
| Ситуация | Возможная обработка |
|---|---|
| Корректная комбинация, товары есть | 200 OK |
| Комбинация невозможна, товаров нет | 404 Not Found |
| Некорректный или повторяющийся параметр | 404 или контролируемая нормализация — по логике системы |
| Временное отсутствие товара при существующей категории | Не обязательно 404: оцените состояние страницы и ассортимент |
| Несуществующая страница пагинации | 404 Not Found |
Не нужно автоматически возвращать 404 для каждой комбинации, в которой временно нет товара: если ассортимент восстановится, а сама посадочная страница имеет ценность, потребуется отдельная логика. Также не следует перенаправлять все пустые комбинации на одну общую страницу ошибки — важен корректный HTTP-статус непосредственно на исходном URL.
Внутренняя перелинковка: как не создавать бесконечные маршруты
Поисковый робот обнаруживает новые URL в том числе через внутренние ссылки. Если каждый элемент фильтра реализован как обычная ссылка на новую комбинацию, система может создавать огромное количество маршрутов обхода. Поэтому управлять нужно не только тем, что разрешено индексировать, но и тем, какие ссылки сайт показывает роботам.
- оставлять в постоянной навигации ссылки на основные категории и SEO-посадочные страницы;
- не превращать каждую сортировку в отдельную индексируемую ссылку;
- не генерировать бесконечные ссылки на произвольные диапазоны цены;
- проверить, какие URL создаются при выборе нескольких значений одного фильтра;
- не полагаться исключительно на JavaScript, чтобы скрыть ненужные ссылки от робота.
Нужен ли rel="nofollow" на фильтрах? Google допускает его использование на ссылках, ведущих к ненужным страницам фильтрации, но это не универсальная замена robots.txt или нормальной архитектуре URL. Для эффекта необходимо последовательно использовать nofollow на всех ссылках, ведущих к конкретному URL: если на этот же адрес ведёт другая обычная ссылка, полного ограничения обхода не будет.
Пагинация и фасетная навигация: отдельная зона риска
Особенно сложные проблемы возникают, когда фильтры объединяются с пагинацией:
/catalog/shoes/?brand=nike
/catalog/shoes/?brand=nike&page=2
/catalog/shoes/?brand=nike&page=3
/catalog/shoes/?brand=nike&color=black
/catalog/shoes/?brand=nike&color=black&page=2
/catalog/shoes/?brand=nike&color=black&page=3
В результате каждая комбинация фильтров может создать собственную последовательность страниц. При аудите необходимо проверить:
- имеет ли каждая страница пагинации уникальный URL;
- не возвращает ли несуществующая страница код 200;
- не ведут ли все страницы пагинации canonical на первую страницу;
- доступны ли товары с последующих страниц через внутренние ссылки;
- не создаются ли дубли из-за разных параметров сортировки;
- не блокируется ли нужная пагинация одновременно с техническими фильтрами.
Пагинация требует отдельной стратегии: нельзя механически применять к ней правила, предназначенные для сортировки или пользовательских фильтров.
Официальные рекомендации: Google — Managing crawling of faceted navigation URLs.
Часть 5. Внедрение и контроль
Ручная обработка каждой комбинации не масштабируется. Правильная стратегия — управлять группами URL и проверять результат в динамике.
Автоматизация управления фасетной навигацией
Для большого интернет-магазина полезно реализовать централизованную систему управления фасетными URL: каждый параметр получает собственную категорию и правила обработки.
{
  "brand": {
    "seo_candidate": true,
    "indexable": "conditional",
    "canonical": "self"
  },
  "color": {
    "seo_candidate": true,
    "indexable": "conditional",
    "canonical": "self"
  },
  "sort": {
    "seo_candidate": false,
    "indexable": false,
    "canonical": "parent"
  },
  "view": {
    "seo_candidate": false,
    "indexable": false,
    "canonical": "parent"
  },
  "per_page": {
    "seo_candidate": false,
    "indexable": false,
    "canonical": "parent"
  }
}
Это демонстрационная конфигурация, а не готовый файл для установки. Реальная реализация должна учитывать сочетания параметров, правила конкретной CMS, доступность страниц для обхода и фактическую поисковую ценность комбинаций.
Что можно автоматизировать
- сбор всех доступных параметров фильтрации и количества возможных комбинаций;
- обнаружение дублей и перестановок параметров;
- выявление комбинаций с нулевым количеством товаров;
- сопоставление фильтров с семантическим спросом;
- генерацию списка SEO-посадочных страниц;
- контроль canonical, meta robots и состава sitemap;
- мониторинг обращений поисковых роботов к параметрическим URL.
При такой архитектуре SEO-специалист управляет не отдельными адресами, а правилами генерации и обработки целых групп URL.
Демонстрационный кейс
Важно
Ниже приведён полностью смоделированный пример для демонстрации методики. Это не реальный клиентский проект и не подтверждённый результат SEO-работ. Цифры можно заменить на данные собственного аудита.
Предположим, мы анализируем интернет-магазин строительных и отделочных материалов: 120 основных категорий, около 18 000 товарных карточек, 7 основных параметров фильтрации, сортировка по цене и популярности, фильтры по производителю, назначению, размеру, материалу и наличию.
| Показатель | До оптимизации |
|---|---|
| Обнаруженные URL каталога и фильтров | 486 000 |
| URL с параметрами фильтрации | 312 000 |
| Комбинации с сортировкой | 74 000 |
| Дубли из-за порядка параметров | 38 000 |
| URL с пустыми результатами | 21 000 |
| Доля запросов Googlebot к техническим комбинациям | 46% |
| Посадочные страницы с подтверждённым спросом | 86 |
Что обнаружили
- Один и тот же набор фильтров формировал несколько URL из-за разного порядка параметров.
- Сортировка по цене создавала дополнительные адреса, доступные для обхода.
- В sitemap присутствовали отдельные URL фильтров, не предназначенные для самостоятельной индексации.
- Некоторые комбинации с нулевым количеством товаров возвращали 200 OK.
- Часть ценных сочетаний характеристик не имела постоянных SEO-адресов.
- Внутренние ссылки позволяли роботам переходить к множеству технических комбинаций.
Что было сделано
- Сегментация параметров. Все параметры разделены на три группы: потенциально индексируемые, пользовательские и технические.
- Создание SEO-посадочных страниц. Для 86 комбинаций с подтверждённым спросом созданы постоянные адреса и отдельные метаданные.
- Нормализация URL. Реализован единый порядок параметров, устранены повторяющиеся и пустые параметры.
- Настройка canonical. Для ценных посадочных — self-referencing canonical, для вариантов сортировки и отображения — объединение с основной категорией.
- Настройка robots.txt. После проверки URL-модели ограничен обход ненужных групп параметров; ценные страницы оставлены доступными для сканирования.
- Обработка пустых комбинаций. Для невозможных комбинаций и несуществующих страниц настроены корректные HTTP-статусы.
- Очистка sitemap и перелинковки. В карту сайта включены только индексируемые URL, ссылки на технические комбинации пересмотрены.
| Показатель | До | После |
|---|---|---|
| Обнаруженные технические URL | 486 000 | 112 000 |
| Доля запросов Googlebot к техническим комбинациям | 46% | 14% |
| Дубли из-за порядка параметров | 38 000 | 1 200 |
| Пустые комбинации с ответом 200 | 21 000 | 0 |
| SEO-посадочные страницы | 86 кандидатов | 86 контролируемых URL |
В этой модели число обнаруживаемых технических URL сократилось примерно на 77%, а доля запросов Googlebot к техническим комбинациям снизилась с 46% до 14%. Уменьшение количества URL само по себе не является конечной целью: главная задача — направить ресурсы сканирования на полезные страницы и сохранить доступность ценных категорий и товаров.
Особенности реализации на Bitrix, WooCommerce и Shopify
Конкретная реализация зависит от CMS, но задача остаётся одинаковой: контролировать генерацию URL и отделять пользовательские фильтры от SEO-посадочных страниц.
1С-Битрикс
- какие URL формирует умный фильтр и используются ли ЧПУ для отдельных значений;
- какие параметры появляются при выборе нескольких характеристик;
- как формируются canonical и meta robots;
- не попадают ли технические URL в sitemap;
- как работают правила robots.txt для параметров;
- не создаются ли дубли при сбросе фильтра и изменении порядка выбора значений.
WooCommerce
- параметры атрибутов товаров, фильтры цены и рейтинга;
- сочетания параметров сортировки и поведение AJAX-фильтрации;
- настройки canonical и robots;
- влияние SEO-плагинов на обработку параметрических страниц.
Особенно важно убедиться, что разные плагины не формируют конфликтующие canonical и meta robots.
Shopify
- структура URL коллекций и параметры фильтров;
- параметры сортировки и обработка вариантов товара;
- дублирующиеся URL коллекций;
- особенности canonical и sitemap.
Для всех трёх платформ принцип одинаков: нельзя переносить один универсальный набор правил без проверки фактической структуры URL и логики CMS.
Контроль после внедрения
После изменений нельзя ограничиваться проверкой robots.txt или нескольких URL вручную: необходимо контролировать поведение сайта и роботов в динамике.
| Период | Что проверять |
|---|---|
| Сразу после внедрения | HTTP-статусы, canonical, robots, доступность важных URL, sitemap |
| Через 7 дней | Логи поисковых роботов, новые параметрические URL, ошибки сервера |
| Через 14 дней | Изменение структуры обхода и появление новых дублей |
| Через 30 дней | Отчёты индексирования, состояние SEO-посадочных страниц, динамика обхода |
| Через 60–90 дней | Долгосрочная динамика индексации, органических входов и поисковой видимости |
Сроки условные: поисковые системы не обязаны обновлять состояние всех URL по заданному графику. Важно оценивать тренд, а не ожидать мгновенного результата после внесения изменений.
Чек-лист технического аудита
Отмечайте выполненные пункты — прогресс виден сразу. Сбросится он при перезагрузке страницы.
Выводы: фасетная навигация — это задача архитектуры
Фасетная навигация — необходимый элемент современного интернет-магазина. Без технического контроля она превращает каталог в практически бесконечное пространство URL.
Роботы получают множество похожих страниц, сервер обрабатывает лишние запросы, а SEO-специалист сталкивается с дублями, проблемами индексации и неуправляемой структурой сайта. Правильная оптимизация начинается не с массового закрытия параметров, а с анализа архитектуры фильтрации.
Нужно определить:
- какие комбинации соответствуют реальному поисковому спросу;
- какие фильтры должны оставаться только пользовательским инструментом;
- какие URL необходимо нормализовать;
- где применять canonical, noindex и robots.txt;
- как обрабатывать пустые комбинации;
- какие страницы должны быть доступны через внутреннюю перелинковку;
- как контролировать поведение поисковых роботов после внедрения изменений.
В результате фасетная навигация перестаёт быть неконтролируемым генератором URL и становится управляемой частью архитектуры интернет-магазина.
Частые вопросы
Сколько фильтров можно оставить открытыми для индексации?
Столько, сколько отвечает подтверждённому спросу. Критериев ровно три: есть ли реальные поисковые запросы, достаточно ли товаров для полноценной страницы и отличается ли она от родительской категории. Количество само по себе не ограничение — важна ценность каждой отдельной комбинации.
Что выбрать: закрыть фильтр в robots.txt или поставить noindex?
От цели. Нужно сэкономить краулинговый бюджет — robots.txt. Нужно, чтобы страница оставалась доступной пользователям, но исчезла из индекса, — noindex. Оба инструмента на одном URL не работают вместе: закрытый адрес робот не откроет и директиву не прочитает.
Нужно ли закрывать сортировку?
Почти всегда да: сортировка не создаёт самостоятельного поискового спроса, но легко умножает число URL. Достаточно правила в robots.txt и canonical на основную категорию. Исключение — случаи, когда конкретная сортировка реально используется в спросе, например «цвет: скидка».
Что делать, если фильтры реализованы на JavaScript?
Проверьте, что ссылки и содержимое доступны в отрендеренном HTML, а состояние фильтра не подставляется только после клика. Фильтры, существующие лишь в JavaScript без ссылок, для робота часто просто не существуют — и наоборот, они могут порождать URL, которых нет в разметке.
Как быстро проверить, что robots.txt и noindex не конфликтуют?
Три шага: откройте проверку URL в Search Console для конкретного параметрического адреса, посмотрите раздел «Обход и индексация» и убедитесь, что страница доступна роботу и содержит нужную директиву. Затем откройте сам файл robots.txt и найдите правило, которое этот URL закрывает. Если правило есть, а noindex стоит — это конфликт.
Сколько ждать эффект после внедрения правил?
Гарантированных сроков нет. Первые изменения в структуре обхода обычно видны в логах через несколько дней, изменения индексации — в течение пары месяцев, эффект на видимость — отсроченно. Поэтому важно фиксировать базовые метрики до внедрения и оценивать тренд, а не разовую проверку.
Материал подготовлен для технических специалистов, SEO-специалистов и владельцев интернет-магазинов. Приведённые числовые кейсы являются демонстрационными моделями, а не результатами реальных клиентских проектов.
Нужен технический аудит фильтров интернет-магазина?
Проведу анализ структуры URL, фасетной навигации, параметров фильтрации, индексации, canonical, robots.txt и логов поисковых роботов.
Помогу определить, какие страницы действительно имеют потенциал органического продвижения, а какие создают лишнюю нагрузку на обход сайта. Работаю с техническим SEO, крупными каталогами и проблемами индексации в Google и Яндексе.
Обсудить технический аудит в TelegramИсточники и техническая документация
- Google Search Central — Managing crawling of faceted navigation URLs
- Google Search Central — Designing a URL structure for ecommerce websites
- Google Search Central — How to specify a canonical URL
- Search Engine Land — Faceted navigation in SEO: Best practices to avoid issues
- Vercel — Faceted navigation SEO for headless storefronts
SEO TITLE: Faceted Navigation SEO — оптимизация фильтров интернет-магазина. Рекомендуемый URL: faceted-navigation-seo. Canonical: https://seoprof74.ru/stati-seo-i-marketing/faceted-navigation-seo — перед публикацией проверьте фактический адрес страницы в Tilda.
