техническое seo·разбор индексации
Index Bloat: как сайт раздувает поисковый индекс мусорными страницами и что с этим делать
Сайт растёт: появляются разделы, товары, фильтры, сортировки и параметры URL. Индекс при этом растёт быстрее, чем полезный контент. Разбираем, откуда берутся лишние адреса, как их обнаружить за 30 минут и какими техническими средствами вернуть сайту управляемую структуру.
главное за 30 секунд
- Индекс растёт не от контента, а от комбинаций URL: фильтров, сортировок, меток и параметров.
- Проблема не в размере индекса, а в том, какие страницы в него попадают и какую долю обхода они съедают.
- Решение — управление обходом: canonical, noindex, robots.txt, коды ответа и правила генерации адресов.
Есть одна проблема, которую владельцы сайтов часто замечают слишком поздно. Сайт постепенно растёт, появляются новые разделы, товары, статьи, фильтры, дополнительные параметры URL. Казалось бы, всё хорошо: чем больше страниц, тем больше возможностей попасть в поисковую выдачу.
Но проходит время, и выясняется, что поисковые системы обнаружили тысячи адресов, которые вообще не планировалось продвигать. В индексе оказываются страницы сортировки, комбинации фильтров, технические URL, дубли карточек товаров и другие варианты одного и того же содержимого.
Владелец сайта смотрит на количество проиндексированных страниц и радуется росту. А SEO-специалист открывает отчёты и понимает, что значительная часть этих URL не приносит никакой пользы.
Такую ситуацию часто называют Index Bloat — раздуванием поискового индекса.
В этой статье разберём, откуда берутся лишние страницы, почему особенно часто проблема встречается в интернет-магазинах, как обнаружить индексный мусор и какие технические решения помогут привести структуру сайта в порядок.
Что такое Index Bloat простыми словами
Index Bloat — неофициальный SEO-термин, которым описывают ситуацию, когда сайт создаёт или допускает обнаружение большого количества URL с низкой ценностью для поиска: дублей, технических страниц, комбинаций фильтров, параметров сортировки и других вариантов контента, не имеющих самостоятельной поисковой ценности.
Представим интернет-магазин строительных материалов. В каталоге есть категория «Кирпич», несколько производителей, разные цвета, размеры и ценовые диапазоны.
Основная страница категории имеет адрес:
https://example.ru/katalog/kirpich/Но пользователь может выбрать производителя, установить диапазон цен, отсортировать товары и применить дополнительные фильтры.
В результате появляются адреса:
https://example.ru/katalog/kirpich/filter/manufacturer-is-braer/

https://example.ru/katalog/kirpich/filter/price-from-100-to-500/

https://example.ru/katalog/kirpich/filter/manufacturer-is-braer/price-from-100-to-500/

https://example.ru/katalog/kirpich/?sort=price

https://example.ru/katalog/kirpich/?sort=popular
Для пользователя это удобный функционал. Он помогает быстро найти нужный товар.
Но для поисковой системы каждый доступный URL может оказаться отдельной страницей, которую необходимо обнаружить, загрузить и оценить.
Если таких комбинаций тысячи, сайт постепенно создаёт огромное пространство URL, значительная часть которого не представляет самостоятельной ценности для органического поиска.
Сколько адресов на самом деле создаёт каталог
Пространство комбинаций считается как произведение значений. Возьмём типовую категорию: производитель — 10 значений, цвет — 12, размер — 15, материал — 8, назначение — 6.
10 × 12 × 15 × 8 × 6 = 86 400 адресов на одну категорию. Добавим четыре варианта сортировки — получим 345 600. При двадцати категориях такого каталога речь уже идёт о семи миллионах URL, которые система способна сгенерировать.
Обойти робот их, конечно, не станет: поисковики отсекают нишевые и пустые комбинации. Но даже 3% от миллиона — это 30 тысяч адресов, которые нужно обойти раньше, чем робот доберётся до новых товаров. Именно этот «хвост» и съедает бюджет обхода.
Почему Index Bloat возникает на сайтах
Причин может быть несколько. Причём далеко не всегда проблема связана с ошибками программиста или неправильными настройками CMS. Иногда индексный мусор появляется из-за вполне полезных функций сайта, которые никто не продумал с точки зрения SEO.
1. Фильтры интернет-магазинов
Это один из наиболее распространённых источников большого количества URL.
Современный каталог может иметь десятки характеристик:
- производитель;
- цвет;
- размер;
- материал;
- стоимость;
- наличие на складе;
- назначение товара;
- технические характеристики.
Каждая характеристика может иметь несколько значений. Пользователь способен комбинировать их практически в любом порядке.
В результате количество возможных комбинаций быстро растёт.
Например, если у категории есть пять характеристик и каждая может принимать десять значений, потенциальное пространство комбинаций становится очень большим. А если разрешить выбирать несколько значений одновременно, число вариантов увеличивается ещё сильнее.
Само наличие фильтров не является проблемой. Проблема возникает, когда все комбинации становятся доступными поисковым роботам, хотя большинство из них не имеет самостоятельного поискового спроса.
2. Сортировка товаров
Многие интернет-магазины позволяют сортировать каталог по цене, популярности, рейтингу, новизне и другим параметрам.
При этом содержимое страницы практически не меняется: те же товары просто отображаются в другом порядке.
Если сортировка формирует отдельный URL, поисковый робот может обнаружить несколько вариантов одной категории.
Например:
/catalog/kirpich/

/catalog/kirpich/?sort=price

/catalog/kirpich/?sort=rating

/catalog/kirpich/?sort=popular
Для пользователя это разные способы просмотра каталога. Для поисковой системы они часто представляют собой варианты одной и той же страницы.
Если такие адреса не контролировать, количество URL начинает расти без реального расширения полезного контента.
3. Параметры URL и UTM-метки
Отдельная проблема — различные параметры, которые добавляются к адресам страниц.
Например:
https://example.ru/uslugi/seo/

https://example.ru/uslugi/seo/?utm_source=telegram

https://example.ru/uslugi/seo/?utm_medium=cpc

https://example.ru/uslugi/seo/?from=advertising
В большинстве случаев пользователь получает одну и ту же страницу, но адреса отличаются.
Параметры могут появляться из-за рекламных кампаний, систем аналитики, партнёрских переходов, фильтров и работы CMS.
Если сайт не сообщает поисковым системам, какой URL является основным, возникает риск накопления дублей.
4. Пагинация и страницы с параметрами
В каталогах и блогах часто используются страницы с постраничной навигацией.
Например:
/blog/

/blog/page/2/

/blog/page/3/

/blog/page/4/
Сама по себе пагинация не является индексным мусором. Наоборот, она помогает поисковым роботам находить товары и материалы, которые не помещаются на первой странице.
Но проблемы возникают, когда система генерирует бесконечные или бессмысленные варианты пагинации, например страницы за пределами существующего количества товаров.
Также стоит проверять комбинации пагинации с фильтрами и сортировками. Они могут создавать огромное количество дополнительных URL.
5. Дубли карточек товаров и категорий
Некоторые CMS позволяют размещать одну и ту же карточку товара в нескольких категориях.
Если при этом для каждого размещения формируется отдельный адрес, поисковая система может обнаружить несколько URL с одинаковым или практически одинаковым содержимым.
Похожая ситуация возникает, когда один товар доступен по нескольким адресам из-за особенностей маршрутизации сайта.
В результате вместо одной основной страницы поисковик получает несколько конкурирующих вариантов.
6. Технические и служебные страницы
В индекс могут попадать URL, которые вообще не предназначены для поискового продвижения:
- страницы внутреннего поиска по сайту;
- страницы результатов фильтрации без товаров;
- тестовые страницы;
- временные посадочные страницы;
- служебные разделы;
- дубли страниц с разными окончаниями URL;
- адреса с идентификаторами сессий.
Иногда такие страницы появляются после обновления CMS, изменения структуры каталога или установки нового модуля.
Три подхода к URL фильтра и почему выбор важен
| Подход | Пример | Сильная сторона | Слабая сторона |
|---|---|---|---|
| Параметр в пути | /katalog/kirpich/filter/manufacturer-is-braer/ | Читаемый адрес, удобно расставлять приоритеты | Выглядит как отдельная страница; править robots.txt по шаблону неудобно |
| Query-параметр | /katalog/kirpich/?manufacturer=braer | Один шаблон правила закрывает всё сразу | Менее «нативный» вид, часть систем делает редирект |
| JS-параметр | /katalog/kirpich/?js=1&m=braer | Управляется на клиенте, роботу адрес не предъявляется | Страница без JS недоступна, хуже кэш и ссылки |
Практический вывод: держать фильтры в query-параметрах и управлять ими одним правилом на уровне шаблона дешевле, чем бороться с тысячами адресов поштучно. Фильтры с реальным спросом при этом никуда не денутся — им можно выдать собственный canonical и полноценное описание.
Чем Index Bloat может мешать SEO-продвижению
Здесь важно сразу уточнить один момент: большое количество страниц в индексе само по себе не означает санкции поисковой системы или автоматического падения позиций.
У крупного интернет-магазина вполне может быть несколько сотен тысяч полезных URL. А у небольшого сайта даже несколько десятков технических дублей могут свидетельствовать о проблемах с архитектурой.
Важен не абсолютный размер индекса, а качество и назначение страниц, которые в него попадают.
1. Неэффективное использование ресурсов обхода
Поисковые роботы располагают ограниченными ресурсами для обхода каждого сайта. Если они постоянно обнаруживают множество однотипных URL, часть времени может уходить на повторное сканирование страниц, которые практически не меняют содержимое.
Особенно это актуально для крупных сайтов, интернет-магазинов и ресурсов с постоянно обновляемым каталогом.
Вместо того чтобы обнаруживать новые товары, важные категории и обновлённые материалы, робот может тратить ресурсы на многочисленные варианты сортировок и фильтров.
Google отдельно описывает эту проблему в документации по управлению обходом фасетной навигации: большое количество URL, создаваемых фильтрами, может приводить к избыточному сканированию и замедлению обнаружения полезных страниц.
2. Дубли конкурируют между собой
Если несколько страниц содержат практически одинаковую информацию и ориентированы на один поисковый интент, поисковой системе приходится определять, какую из них показывать в результатах поиска.
В результате основная страница может уступить место менее подходящему варианту.
Например, вместо основной категории «Кирпич» в поиске может появиться URL с параметром сортировки или случайной комбинацией фильтров.
Яндекс также указывает, что дубли могут конкурировать между собой, а робот может исключить из поиска страницу, которая действительно важна владельцу сайта.
3. Размывание структуры сайта
Когда на сайте появляется большое количество технических страниц, становится сложнее контролировать внутреннюю архитектуру.
Внутренние ссылки могут вести на разные варианты одного и того же раздела. Карта сайта может содержать лишние адреса. А отчёты аналитики становятся менее понятными.
В результате SEO-специалисту приходится тратить время не на развитие полезных посадочных страниц, а на постоянную борьбу с последствиями неконтролируемой генерации URL.
4. Проблемы с определением канонических страниц
Если на сайте существует несколько версий одной страницы, поисковая система должна определить предпочтительный адрес.
При неправильной настройке canonical, противоречивых сигналах или различиях в содержимом робот может выбрать не тот URL, который владелец считает основным.
Это способно приводить к тому, что в поиске участвуют нежелательные варианты страниц, а нужные адреса исключаются как дубли.
Что именно теряет робот
Глубина обхода — это расстояние от главной страницы до полезного документа. Каждый уровень фильтра добавляет ещё один. Если товар лежит на глубине 5, а из-за конструкции URL появились четыре промежуточных слоя, товар окажется на глубине 9 — а глубокие страницы робот обходит заметно реже.
Удобная метрика для отчётности: коэффициент полезного обхода = проиндексированные полезные страницы ÷ число запросов роботов к мусорным URL. Если из ста запросов к сайту полезными оказываются пять, половина бюджета обхода потрачена впустую. Для крупного магазина ориентир — выше 0,3; значение ниже 0,1 говорит о том, что структуру пора пересобирать.
Как обнаружить Index Bloat на сайте
Теперь перейдём к практике. Для начала необходимо понять, какие страницы реально существуют, какие обнаружены поисковиками и сколько среди них URL, не имеющих самостоятельной ценности.
Я бы не ограничивался одним инструментом. Лучше сопоставить данные нескольких источников.
1. Проверка Google Search Console
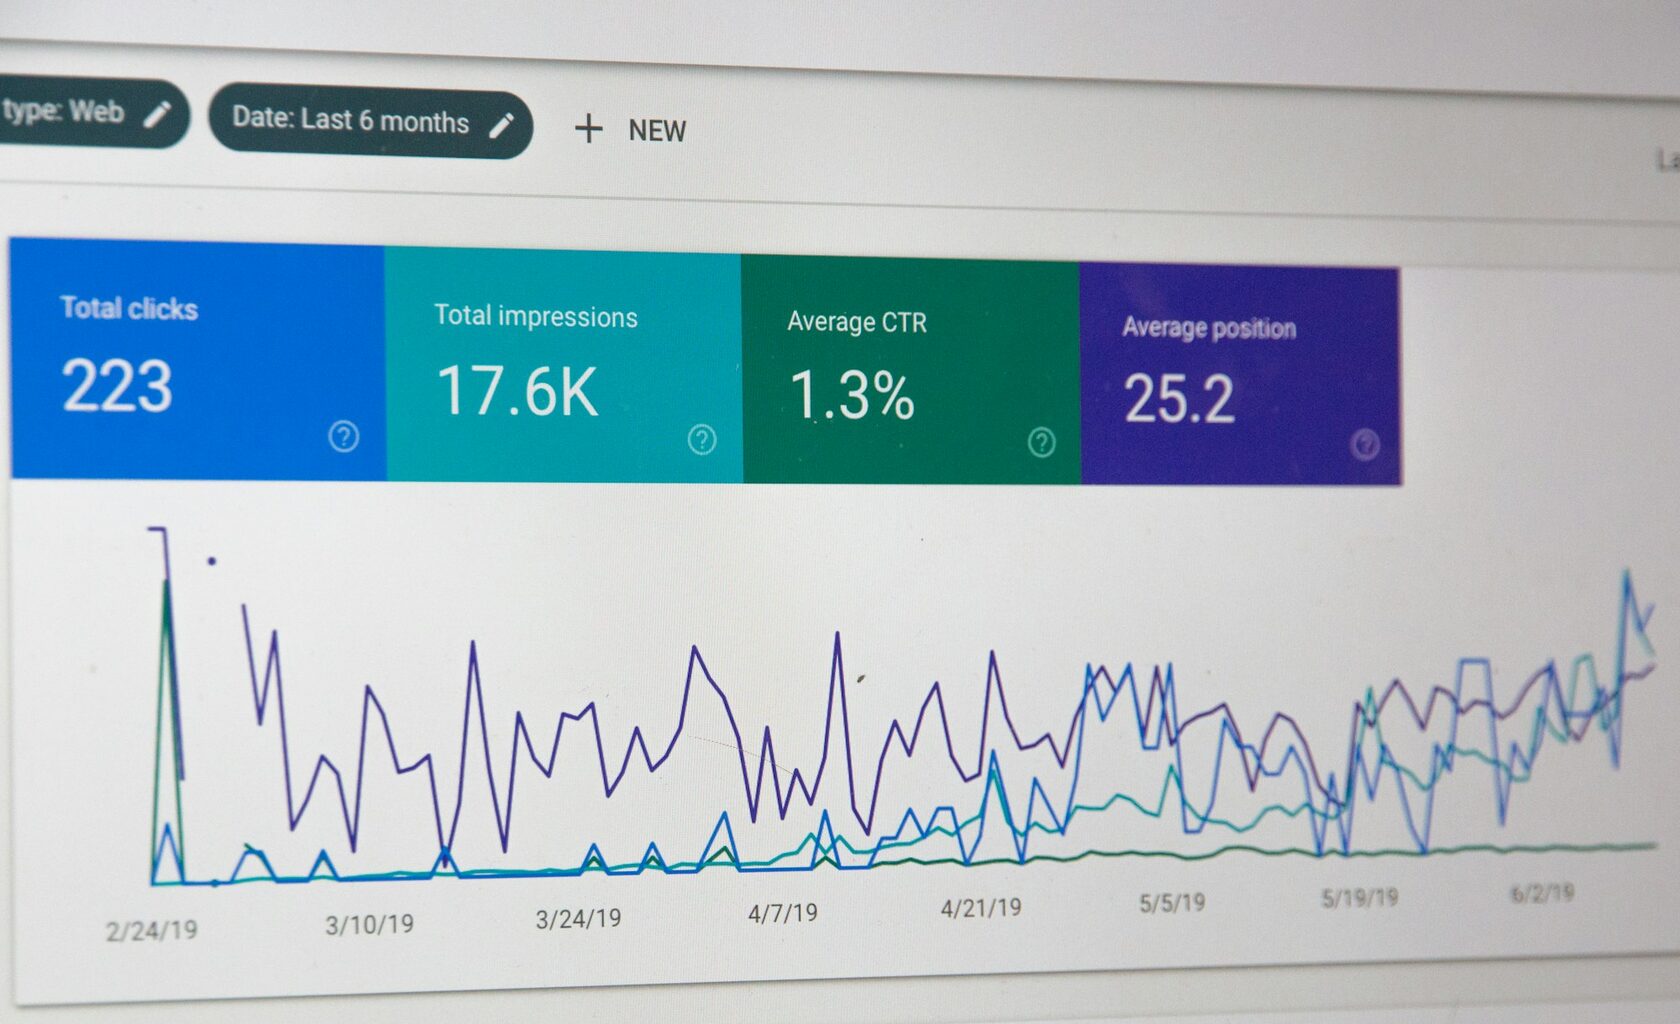
Первым делом стоит открыть Google Search Console и перейти в отчёт об индексировании страниц.
Там можно посмотреть, какие URL проиндексированы, а какие исключены из поиска.
Особое внимание стоит уделить следующим статусам:
- Duplicate without user-selected canonical — дубли без указанного владельцем канонического адреса;
- Duplicate, Google chose different canonical than user — Google выбрал другой канонический URL;
- Discovered - currently not indexed — URL обнаружен, но пока не проиндексирован;
- Crawled - currently not indexed — URL просканирован, но не включён в индекс;
- Alternate page with proper canonical tag — альтернативная страница с корректным canonical.
Важно: не каждый исключённый URL является проблемой. Например, альтернативная страница с правильно настроенным canonical может быть исключена совершенно ожидаемо.
Нужно искать именно закономерности: большое количество однотипных URL, повторяющиеся параметры и страницы, которые не должны были участвовать в поиске.
Инструмент: Google Search Console.
2. Проверка Яндекс Вебмастера
Для сайтов, продвигаемых в Яндексе, необходимо изучить раздел «Индексирование» и отчёт «Страницы в поиске».
Обращаем внимание на страницы со статусами:
- Дубль;
- Исключена по Clean-param;
- Малоценная или маловостребованная страница;
- Ошибка ответа сервера;
- Запрещена к индексированию.
Дополнительно полезно посмотреть структуру сайта в Вебмастере и сравнить количество обнаруженных URL с реальной структурой проекта.
Если в отчётах появляются большие группы страниц с одинаковыми параметрами, это повод проверить генерацию URL.
Инструмент: Яндекс Вебмастер.
3. Анализ через Screaming Frog SEO Spider
Для технического аудита удобно использовать Screaming Frog SEO Spider.
Программа обходит сайт и собирает информацию о найденных URL, HTTP-кодах, метатегах, canonical, заголовках и внутренних ссылках.
Для поиска признаков Index Bloat полезно проверить:
- страницы с одинаковыми или похожими Title;
- дубли Description;
- повторяющиеся H1;
- URL с параметрами;
- страницы с одинаковым содержимым;
- страницы с canonical на другой адрес;
- страницы без внутренних входящих ссылок;
- необычные цепочки перенаправлений.
Отдельно стоит использовать фильтрацию URL по параметрам. Например, найти все адреса, содержащие sort, filter, price, page, utm и другие характерные элементы.
Но есть важный нюанс: Screaming Frog видит только те URL, которые ему удалось обнаружить в рамках выбранной конфигурации обхода, подключённых источников и ограничений. Поэтому его результаты нужно сопоставлять с данными поисковых систем, Sitemap и серверных логов.
Официальный сайт: Screaming Frog SEO Spider.
4. Анализ sitemap.xml
Карта сайта должна содержать адреса страниц, которые владелец действительно хочет предложить поисковым системам для индексирования.
Если в sitemap.xml попадают страницы сортировки, технические URL, параметры фильтров и дубли, это дополнительный сигнал о проблемах с архитектурой.
Проверьте:
- нет ли в Sitemap URL с UTM-метками;
- не попадают ли туда страницы сортировки;
- соответствуют ли адреса каноническим версиям;
- не включены ли удалённые страницы;
- не добавляются ли автоматически технические комбинации фильтров.
Не стоит пытаться использовать Sitemap как инструмент принудительного удаления страниц. Он предназначен прежде всего для передачи поисковикам информации о предпочтительных URL сайта.
5. Анализ серверных логов
Если сайт крупный, я бы обязательно изучил серверные логи.
Именно они позволяют увидеть, какие URL реально запрашивают поисковые роботы и как часто это происходит.
Например, можно обнаружить, что Googlebot постоянно обращается к тысячам комбинаций фильтров, хотя полезных страниц в каталоге значительно меньше.
При анализе стоит сгруппировать запросы по:
- типу URL;
- параметрам запроса;
- HTTP-кодам ответа;
- частоте обращений;
- типу поискового робота;
- разделу сайта.
Для более глубокого изучения этой темы рекомендую материал Log File Analysis: анализ серверных логов и работа с файлами логов в SEO.
Проверка за 30 минут, без полного краулера
Если полный аудит пока не в планах, следующий список закрывает большинство кейсов Index Bloat:
- Скачать sitemap.xml и посчитать адреса с параметрами — их доля выше 5% уже тревожный сигнал.
- Сравнить число URL в Sitemap с числом страниц в Search Console: расхождение показывает, что робот знает больше, чем вы отдаёте намеренно.
- Выгрузить URL из отчёта об индексации, сгруппировать их по типу параметра и посчитать размер каждой группы.
- Открыть robots.txt и проверить, есть ли правила для sort, utm, filter и других шаблонов.
- Посмотреть логи: топ-20 URL по числу запросов роботов за неделю.
- Сопоставить топ логов со списком страниц Sitemap — так видно, что робот обходит мимо карты сайта.
# сколько URL с параметрами в карте сайта
grep -o '<loc>[^<]*?[^<]*</loc>' sitemap.xml | grep -c '?'

# сколько адресов приходит от роботов
grep 'Googlebot\|YandexBot' access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -20Как правильно бороться с Index Bloat
Самое главное — не начинать с массового закрытия всех URL, которые выглядят подозрительно.
Иногда фильтр по производителю действительно создаёт полезную страницу с самостоятельным поисковым спросом. А иногда комбинация десяти характеристик формирует практически бесполезный адрес.
Задача SEO-специалиста — разделить эти ситуации.
1. Определить страницы, которые должны индексироваться
Для начала необходимо сформировать список URL, имеющих самостоятельную ценность для поиска.
Например:
- основные категории каталога;
- важные подкатегории;
- страницы популярных производителей;
- посадочные страницы под востребованные комбинации характеристик;
- карточки товаров с самостоятельным поисковым спросом;
- информационные статьи и полезные материалы.
Такие страницы необходимо сохранить доступными для поисковых роботов и включить в общую стратегию продвижения.
Не нужно закрывать все фильтры только потому, что они создают дополнительные URL. Некоторые фильтры могут быть полноценными SEO-посадочными страницами.
1. белый список URL
   → остаются в индексе, входят в sitemap.xml

2. объединяемые URL
   → canonical на основной адрес

3. служебные URL
   → noindex, follow

4. несуществующие комбинации
   → 404 / 410
2. Использовать rel="canonical" для дублей
Если несколько URL показывают практически одинаковое содержимое, можно указать предпочтительную версию страницы с помощью атрибута canonical.
Например, на странице сортировки:
Это сообщает поисковой системе, какой адрес предпочтительно считать основным.
Однако canonical — это сигнал, а не безусловная команда. Поисковая система может выбрать другой URL, если считает его более подходящим.
Также важно не объединять страницы, которые действительно имеют разное содержание и самостоятельную ценность.
<link rel="canonical"
      href="https://example.ru/katalog/kirpich/">

<link rel="canonical"
      href="https://example.ru/katalog/kirpich/?manufacturer=braer">
3. Использовать noindex для страниц, которые не должны попадать в поиск
Если страница нужна посетителю, но не должна участвовать в поисковой выдаче, можно использовать директиву noindex.
Например, для служебной страницы внутреннего поиска или определённого технического варианта каталога.
В HTML это выглядит так:
Важно учитывать, что поисковый робот должен иметь возможность загрузить страницу, чтобы увидеть директиву noindex.
Если одновременно закрыть URL в robots.txt, робот может не прочитать метатег и не обработать указание на исключение страницы из поиска.
<meta name="robots"
      content="noindex, follow">

<meta name="googlebot"
      content="noindex, follow">
4. Настроить robots.txt для управления обходом
Robots.txt можно использовать для ограничения обхода URL, которые не нужно сканировать.
Например, если сортировка создаёт множество бесполезных вариантов, можно рассмотреть ограничение соответствующих шаблонов адресов.
Это только иллюстрация. Перед внедрением необходимо проверить реальные URL, синтаксис правил и поведение сайта.
Особенно важно помнить: robots.txt запрещает обход, но сам по себе не гарантирует удаление уже известных URL из поискового индекса.
Если необходимо исключить страницу из поиска с помощью noindex, робот должен иметь возможность её просканировать.
User-agent: *
Disallow: /*?sort=
Disallow: /*?utm_source=
Disallow: /*?utm_medium=

# страница должна остаться открытой,
# чтобы робот увидел noindex
Allow: /katalog/kirpich/filter/
5. Использовать Clean-param в Яндексе
Для сайтов, продвигаемых в Яндексе, полезно учитывать директиву Clean-param.
Она позволяет сообщить роботу, что определённые параметры URL не меняют содержимое страницы и не должны учитываться при формировании адреса в поиске.
Например:
Такой подход может быть полезен для обработки рекламных меток и других параметров, которые не создают самостоятельного контента.
Но применять Clean-param ко всем параметрам подряд нельзя. Если параметр действительно меняет содержимое страницы, его нельзя бездумно игнорировать.
Подробнее: документация Яндекс Вебмастера по Clean-param.
User-agent: Yandex
Clean-param: utm_source&utm_medium&utm_campaign

# параметр manufacturer меняет
# содержимое — его не указываем
Clean-param: ref&from
6. Удалить действительно ненужные страницы
Если URL больше не нужен, не содержит полезной информации и не имеет подходящей замены, правильным решением может быть удаление страницы.
В зависимости от ситуации сервер должен возвращать:
- 404 Not Found — страница не существует;
- 410 Gone — страница удалена окончательно.
Если у страницы есть полноценная замена, можно настроить постоянный редирект 301 на соответствующий адрес.
Не стоит перенаправлять все удалённые страницы на главную. Если содержимое не имеет отношения к главной странице, такой редирект может быть воспринят как некорректный.
# страницы больше нет
HTTP/1.1 404 Not Found

# страница удалена окончательно
HTTP/1.1 410 Gone

# есть равноценная замена
HTTP/1.1 301 Moved Permanently
Location: /katalog/kirpich/filter/braer/Четыре волны вместо одной большой правки
Очистка индекса почти всегда идёт в несколько заходов. Если закрыть всё разом, часть страниц надолго зависнет в выдаче, а часть уйдёт из индекса слишком быстро.
| Волна | Что делаем | Срок |
|---|---|---|
| 1. Разметка | canonical и robots meta на уровне шаблонов, правила генерации URL, чистка Sitemap | 1–2 дня |
| 2. Обход | robots.txt, Clean-param, снятие лишних ссылок из меню, футера и карты сайта | 3–5 дней |
| 3. Исключение | noindex для пользовательских комбинаций, 404/410 для несуществующих, 301 на равноценные замены | 1–2 недели |
| 4. Наблюдение | отчёты Search Console и Вебмастера, серверные логи, корректировка правил | 8–12 недель |
Две ошибки на старте обходятся дороже всего. Первая — закрыть URL одновременно в robots.txt и noindex: робот не сможет прочитать директиву, и страница надолго останется в индексе. Вторая — поставить canonical на страницу, которой затем задают noindex: сигналы начинают противоречить друг другу.
Особое внимание: фильтры интернет-магазинов
На мой взгляд, именно фильтры заслуживают отдельного внимания. Особенно если речь идёт о крупных каталогах с большим количеством товаров и характеристик.
Представим, что у нас есть категория строительных материалов.
Пользователь может выбрать производителя, цену, размер, цвет и другие характеристики. Каждая комбинация создаёт новый URL.
Но далеко не каждая комбинация должна становиться отдельной SEO-страницей.
Я бы разделил фильтры на три группы.
Это комбинации, которые имеют самостоятельный спрос и позволяют сформировать полезную посадочную страницу.
Например:
- кирпич BRAER;
- керамический кирпич;
- облицовочный кирпич;
- кирпич определённого формата или назначения.
Для таких страниц можно подготовить уникальные Title, Description, H1, текстовое описание и понятную структуру товаров.
При этом важно проверить реальный поисковый спрос и убедиться, что страница не является практически полной копией другой посадочной.
Например, пользователь выбрал:
- цену от 100 до 318 рублей;
- определённый цвет;
- наличие на складе;
- сортировку по стоимости.
Такая комбинация может быть удобна посетителю, но не обязательно нужна в поисковой выдаче.
Для неё следует продумать правила canonical, noindex или ограничения обхода в зависимости от того, как именно формируется URL и какую задачу решает страница.
Это страницы, которые не дают пользователю полезного результата:
- фильтр не возвращает ни одного товара;
- выбраны несовместимые характеристики;
- один фильтр применён несколько раз;
- параметры создают бесконечные комбинации;
- страница практически не отличается от исходной категории.
Такие URL не должны бесконтрольно генерироваться и попадать в поисковую инфраструктуру.
Если комбинация действительно не существует, корректным решением может быть ответ 404. Если URL формирует полноценную, но не предназначенную для поиска пользовательскую страницу, нужно выбрать другой подход.
Простое рабочее правило, которое снимает 80% вопросов
- Один параметр + есть спросделаем полноценную посадочную: уникальные Title, H1, текст, вход в Sitemap.
- Один параметр, спроса нетcanonical на базовую категорию, адрес остаётся доступным пользователю.
- Два и более параметровnoindex, follow — страница живёт, но в выдачу не попадает.
- Любая сортировкаcanonical на базу: порядок выдачи не меняет содержимое страницы.
- Комбинация без результатов404, а если параметр осмысленный — 301 на базовую категорию.
Как не навредить сайту при очистке индекса
Здесь хочу отдельно остановиться на распространённой ошибке.
Некоторые специалисты видят в Вебмастере или Search Console большое количество исключённых страниц и начинают массово закрывать всё подряд.
В результате вместе с мусорными URL из поиска могут исчезнуть полезные страницы.
Перед изменениями я рекомендую подготовить таблицу со следующими столбцами:
| Параметр | Что проверяем |
|---|---|
| URL | Адрес страницы |
| Тип страницы | Категория, товар, фильтр, сортировка, дубль |
| Индексация | Есть ли страница в поиске |
| Canonical | Какой адрес указан основным |
| HTTP-код | 200, 301, 404, 410 и другие |
| Трафик | Получает ли URL органические переходы |
| Решение | Оставить, объединить, закрыть, удалить |
Такой подход помогает не принимать решения только на основании количества страниц.
У каждой группы URL должна быть понятная стратегия обработки.
Семь решений, которые делают очистку хуже
- Массовый 301 на главнуюредирект всего подряд на главную выглядит как нерелевантный сброс и обесценивает саму страницу.
- robots.txt и noindex одновременноробот не прочитает noindex, и адрес будет исключён из обхода, но останется в индексе.
- canonical на другой протокол или доменредирект на https и canonical на http противоречат друг другу — робот выберет сам.
- noindex на пагинациипагинация нужна роботу, чтобы дойти до товаров. Закрывать её — значит прятать товары.
- Удаление товара без редиректаесли есть близкий аналог или та же категория — нужен 301, иначе теряются ссылки и позиции.
- Смена URL в период обновления каталогамиграция должна идти малыми партиями с проверкой логов, а не разом перед релизом.
- Мусорные ссылки в интерфейсепока ссылка стоит в меню, футере или карте сайта, робот будет приходить на неё снова.
Пошаговый план устранения Index Bloat
Если я беру сайт на технический аудит и обнаруживаю признаки раздувания индекса, то действую примерно по следующему плану.
- шаг 01Собираю все доступные URL. Использую Sitemap, данные поисковых панелей, результаты сканирования и серверные логи.
- шаг 02Группирую адреса. Отдельно выделяю товары, категории, фильтры, сортировки, параметры и дубли.
- шаг 03Определяю полезные страницы. Проверяю поисковый спрос, трафик, содержание и назначение каждого типа URL.
- шаг 04Проверяю технические сигналы. Анализирую canonical, robots.txt, noindex, HTTP-коды и внутренние ссылки.
- шаг 05Формирую правила индексации. Определяю, какие страницы должны индексироваться, какие объединяться, а какие исключаться.
- шаг 06Внедряю изменения. Корректирую настройки CMS, правила URL, метатеги, Sitemap и серверную конфигурацию.
- шаг 07Проверяю результат. Повторно сканирую сайт и контролирую изменения в Яндекс Вебмастере и Google Search Console.
После внедрения изменений важно не ждать мгновенного результата. Поисковым роботам потребуется время, чтобы повторно посетить страницы и обработать новые сигналы.
Ориентир для контроля: раз в месяц смотреть семь показателей — долю мусорных URL в индексе, глубину обхода, число запросов роботов на одну полезную страницу, долю 4xx в логах, скорость попадания новых товаров в индекс, CTR по группе адресов и соотношение «страниц в индексе» к «полезным страницам». Если после второй волны внедрения эти числа не меняются, значит правила не сработали и пора искать другой источник мусора.
Часто задаваемые вопросы об Index Bloat
Index Bloat — это фильтр или санкция поисковой системы?
Нет. Index Bloat — неофициальный термин для описания ситуации с избыточным количеством малополезных URL. Само наличие таких страниц не означает автоматическое применение санкций.
Большое количество страниц в индексе — это всегда плохо?
Нет. Если все страницы полезны, уникальны и отвечают на реальные запросы пользователей, большой индекс может быть нормальным состоянием крупного сайта. Проблема заключается в бесконтрольном накоплении дублей и технических URL.
Можно ли закрыть все фильтры интернет-магазина через robots.txt?
Технически можно ограничить обход определённых шаблонов URL, но делать это массово без анализа нельзя. Некоторые фильтры могут быть полезными SEO-посадочными страницами. Кроме того, robots.txt не гарантирует удаления уже известных URL из индекса.
Что лучше использовать: canonical или noindex?
Зависит от задачи. Canonical помогает указать предпочтительную версию дублирующей страницы. Noindex используется, когда страницу нужно исключить из поиска, но она может оставаться доступной посетителям. Это разные механизмы, и они не являются взаимозаменяемыми во всех ситуациях.
Поможет ли очистка индекса увеличить позиции сайта?
Гарантировать рост позиций нельзя. Но устранение лишних URL, дублей и ошибок управления обходом может улучшить техническую структуру сайта, снизить ненужную нагрузку на сканирование и помочь поисковым системам эффективнее обнаруживать важные страницы.
Как часто нужно проверять Index Bloat?
Для небольших сайтов достаточно периодического контроля. Для крупных интернет-магазинов, каталогов и проектов с динамическими фильтрами желательно включить такую проверку в регулярный технический SEO-аудит.
Нужно ли вручную удалять мусорные URL из индекса?
Нет, если сигналы настроены правильно. Достаточно один раз выставить canonical или noindex, убрать страницу из внутренних ссылок и Sitemap — дальше робот обработает изменения сам. Ручное удаление через инструменты вебмастеров нужно только для отдельных URL, которые по каким-то причинам не отдают нужный код ответа.
Что делать, если мусорные URL уже приносят трафик?
Сначала проверить источник переходов. Если страница с фильтром даёт клики и конверсии, значит, у неё есть спрос — сначала превратите её в полноценную посадочную, а уже потом решайте, нужна ли она в структуре сайта. Закрывать адреса с реальным трафиком без анализа рискованно: это самый частый способ потерять позиции при очистке.
Заключение
Index Bloat — проблема, которая часто развивается незаметно. Сначала появляются несколько дополнительных URL, затем сотни вариантов фильтров, сортировок и параметров, а спустя время поисковая система обнаруживает огромную структуру страниц, значительная часть которых не имеет самостоятельной ценности.
Самое неприятное, что внешне сайт может работать совершенно нормально. Каталог открывается, товары доступны, фильтры удобны для посетителей. Но с точки зрения поисковой оптимизации структура постепенно становится всё менее управляемой.
Поэтому задача SEO-специалиста заключается не в том, чтобы добиться минимального количества страниц в индексе любой ценой. Нужно сделать так, чтобы поисковые системы могли правильно находить, обходить и выбирать действительно важные страницы сайта.
Особенно внимательно стоит относиться к фильтрам интернет-магазинов, параметрам URL, пагинации и автоматической генерации страниц. Именно здесь чаще всего скрывается источник индексного мусора.
Хорошая новость в том, что Index Bloat — управляемая проблема: он появляется по предсказуемым правилам и исчезает по тем же правилам. Иногда для улучшения SEO не нужно создавать ещё сотню новых страниц. Гораздо полезнее разобраться с теми, которые уже существуют.
услуга
Нужен технический SEO-аудит?
Я занимаюсь внутренней и внешней SEO-оптимизацией, техническими аудитами, анализом индексации и оптимизацией структуры сайтов.
Помогаю находить проблемы, которые мешают поисковым системам правильно обходить и индексировать важные страницы: дубли URL, некорректные фильтры, ошибки canonical, проблемы Sitemap, robots.txt и другие технические недочёты.
Если у вас интернет-магазин или большой каталог, в котором со временем накопились тысячи страниц, можно начать с анализа текущей структуры и состояния индекса.
Стоимость комплексного SEO-продвиженияот 15 000 рублей в месяц
Что входит в работу
- аудитПолная техническая проверка индексации, URL-структуры и сигналов управления обходом.
- разбор индексаГруппировка мусорных адресов по типам и подготовка таблицы решений по каждому URL.
- план внедренияПорядок правок: canonical, noindex, robots.txt, коды ответа, правка Sitemap и внутренних ссылок.
- сопровождениеКонтроль показателей после внедрения: динамика индекса, глубина обхода, поведение роботов в логах.
Полезные источники и документация
- google · developersManaging crawling of faceted navigation URLs
- google · developersCrawl Budget Management
- google · searchConsolidate duplicate URLs
- яндекс · вебмастерКанонический адрес страницы
- яндекс · вебмастерДублирование страниц
- яндекс · вебмастерКак отслеживать индексирование и управлять им
- яндекс · вебмастерДиректива Clean-param
- seoprof74Log File Analysis: анализ серверных логов в SEO
